Модуль верификации библиографических ссылок
С конференции — в продукт
В июне команда Руконтекста участвовала в XXIV всероссийской конференции «Корпоративные библиотечные системы: технологии и инновации» (КорФор-2026) в Санкт-Петербурге и Выборге. Тема года — «Трансформация библиотек: в поиске актуальных форматов и смыслов» — задала разговор о том, чего библиотечному сообществу не хватает в существующих инструментах. На стенде Руконтекста один и тот же запрос от представителей библиотек повторялся снова и снова: системы проверки хорошо ищут заимствования в тексте, но почти не работают со списком литературы — а именно там сегодня концентрируется значительная часть проблем научных работ.
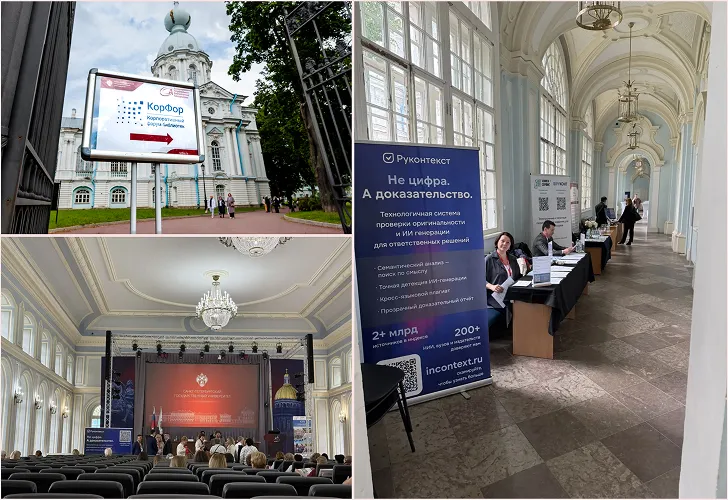
Запрос прозвучал в июне. В августе функция верификации библиографических ссылок вышла в продакшен. Ниже — какую проблему она закрывает и как устроена.
Почему библиография стала проблемой
Качество библиографических ссылок — фундамент академической добросовестности. Ошибки в описании источников, неполнота данных или намеренные искажения подрывают воспроизводимость научных результатов и открывают путь к скрытому плагиату.
Специалисты Российской государственной библиотеки, проанализировав значительный массив научных работ при помощи программного комплекса «Антиплагиат.РГБ», зафиксировали устойчивый перечень недостатков: от фиктивных источников до копирования чужих ошибок. Одновременно лавинообразный рост цифровых публикаций и отсутствие единых стандартов для их описания делают ручной контроль библиографии всё менее эффективным.
Ответом на эти вызовы становятся инструменты интеллектуального анализа текста. Один из свежих примеров — обновление системы Руконтекст: распознавание библиографических ссылок по восьми метрикам и точечная работа с каждой записью.
Сложности с электронными ресурсами
С бурным ростом цифровых источников оформление ссылок на них превратилось в одну из самых острых методических задач. Трудности порождаются нестабильностью сетевых адресов, отсутствием универсальных правил для описания интернет-ресурсов и тем, что действующие ГОСТы далеко не всегда ориентированы на специфику веба.
Наиболее распространённые ошибки:
Неполный комплект метаданных. Авторы зачастую ограничиваются фамилией, заглавием и URL, забывая указать дату обращения, название платформы, системные требования или сведения об ограничениях доступа.
Путаница с датами. Дата публикации материала смешивается с датой последнего обновления страницы, что искажает временную привязку цитируемого содержания.
Искажение имён и заглавий. Неверные инициалы авторов, транслитерация вместо перевода, самостоятельный перевод названий при наличии официальных англоязычных версий.
Ошибки в выходных данных. Даже когда авторы, название и журнал указаны верно, легко ошибиться в номере выпуска, томе или страницах — формально ссылка выглядит аккуратной, но ведёт не туда.
Игнорирование DOI. DOI (Digital Object Identifier) — уникальный цифровой идентификатор, который присваивается публикации один раз и закрепляется за ней навсегда: по нему источник можно найти, даже если страница переехала, а исходный адрес перестал работать. Это надёжный и долговременный ключ доступа, однако ГОСТ не требует его обязательного присутствия в описании. Как следствие, ссылки на источники без DOI становятся «невидимыми» при смене URL.
Несоответствие стандартам и разнобой в оформлении
Даже при наличии нормативной базы авторы нередко смешивают разные системы отсылок: в одной работе соседствуют внутритекстовые, подстрочные и затекстовые ссылки. Подобная эклектика нарушает единообразие и усложняет навигацию. Кроме того, игнорируются локальные требования издательств и вузов, которые могут заметно отличаться от базовых положений ГОСТов. Типичны также пунктуационные ошибки и нарушения стандартов сокращения слов (ГОСТ 7.11, ГОСТ 7.12).
Проблемы вторичного цитирования и плагиат
Опасной практикой остаётся подмена первоисточника вторичным документом. Автор ссылается не на оригинальную работу, а на тот источник, которым пользовался сам, — и однажды допущенная ошибка воспроизводится по цепочке из работы в работу. Сюда же примыкает отсутствие отсылок к конкретным материалам внутри крупных массивов: сборников, баз данных. Некорректное оформление дословных заимствований — пропуск кавычек, неверное указание страниц, отсутствие ссылки — превращает добросовестное цитирование в плагиат.
Результаты массовых проверок научных текстов (РГБ)
Исследования Российской государственной библиотеки выявили системные дефекты справочно-библиографического аппарата. Среди наиболее характерных недостатков: включение в список литературы фиктивных источников; отсутствие единообразия в библиографических описаниях; неуместные ссылки на группу источников вместо конкретной работы; подмена первоисточника вторичным документом; распространение неверных данных вследствие копирования чужих ошибок.
Анализ некорректных заимствований показал, что чаще всего копируются готовые формулировки выводов, обобщений, описания методов и обзоров литературы. Основными источниками таких заимствований выступают труды научных руководителей, близкие по теме и структуре диссертации, а также более ранние публикации самого автора. При этом многие оплошности совершаются начинающими авторами не по злому умыслу, а из-за недостатка знаний.
Отдельный — и быстро растущий — источник фиктивных ссылок появился с распространением нейросетей. Генеративные модели уверенно выдумывают правдоподобные публикации: существующие авторы, реальный журнал, аккуратно оформленный DOI, которого не существует. Причём риск возникает даже без генерации самого текста: достаточно загрузить готовую работу в нейросеть с просьбой поправить оформление списка по ГОСТу — и вернувшийся документ может содержать уже «битые» ссылки, которые в массе текста глазами не видны.
Интеллектуальное распознавание библиографии в системе Руконтекст
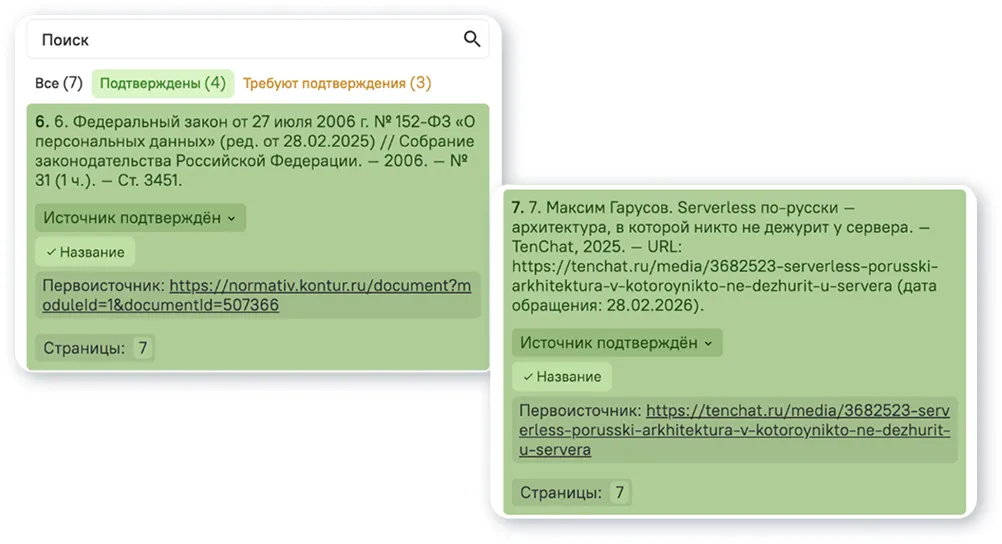
В ходе проверки научного документа система автоматически выделяет библиографический блок и проводит его детальную верификацию. Результат выводится в отчёте отдельным разделом «Список библиографии», а сводная метрика по библиографии появляется рядом с показателями оригинальности и ИИ-детекции.
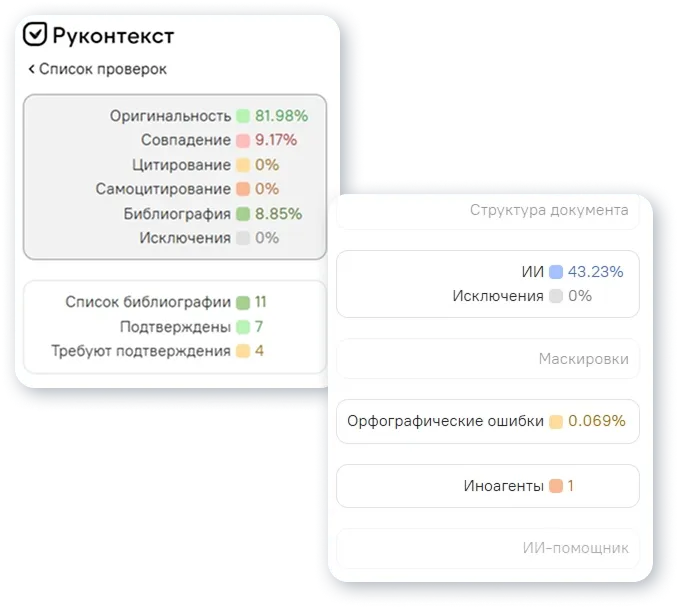
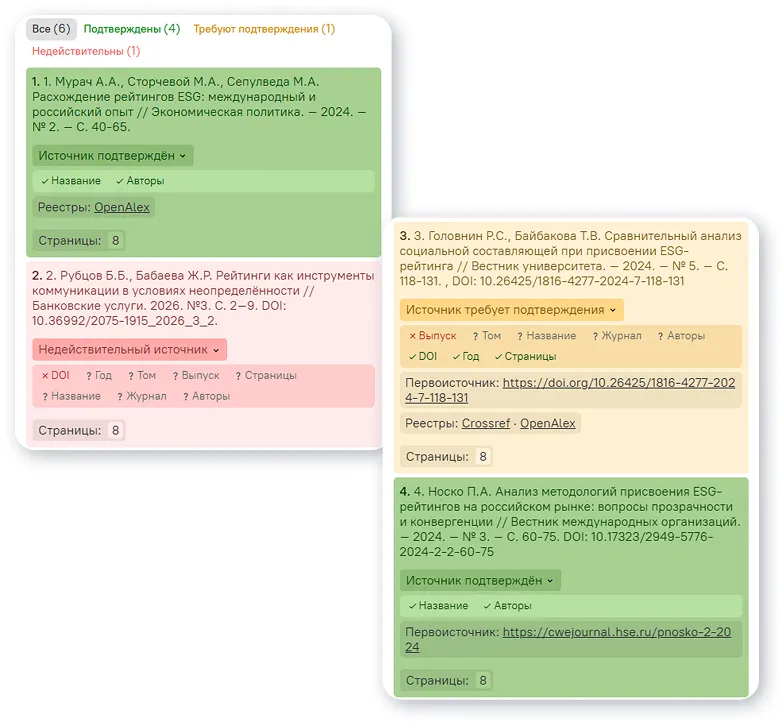
Все найденные библиографические ссылки классифицируются по трём категориям:
Подтверждённые — ссылки, по которым система распознала полный набор признаков и смогла надёжно идентифицировать источник.
Требующие подтверждения — ссылки, по которым совпали лишь несколько признаков; такие записи нуждаются в ручной проверке автором или редактором.
Недействительные — ссылки, которые система признала отсутствующими в верифицируемых базах, зафиксировав расхождение по одному или нескольким ключевым параметрам. Именно сюда по результату сверки попадают в том числе ссылки, выдуманные нейросетями. Категория присваивается консервативно: красную пометку получают только записи, в фиктивности которых система уверена, — неоднозначные случаи направляются в «требующие подтверждения».
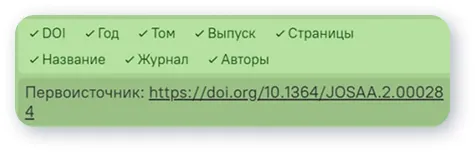
Распознавание осуществляется на основе восьми базовых признаков: DOI, год публикации, том, выпуск, страницы, название, наименование журнала и авторы. Комбинация этих метрик позволяет не только отделить реальные публикации от фиктивных, но и выявить неточности в описании: неверный год, опечатку в названии, отсутствие DOI. Благодаря разделению ссылок на три группы пользователь получает возможность точечно работать с каждым сомнительным элементом, а не перепроверять весь список вручную.
Сверка при этом не ограничивается реестрами научных публикаций. Библиографическая ссылка — не всегда журнальная статья: источником может быть интернет-ресурс, база данных, набор карт. Для таких записей работает собственный поисковый робот системы: он ищет библиографическую запись по открытым источникам в интернете. Проверяется всё, до чего можно дотянуться, — включая источники, которые не покрыты реестрами и DOI.
Что меняется в рабочих процессах
Нормоконтроль. Проверка списка литературы — обязательный этап нормоконтроля выпускных работ: каждый источник сверяется на полноту выходных данных и соответствие ГОСТу, замечания фиксируются в листе нормоконтроля. До сих пор это была полностью ручная работа по каждой записи. С верификацией библиографии список приходит на нормоконтроль уже размеченным: подтверждённые записи не требуют внимания, а категория «требующие подтверждения» фактически формирует готовый рабочий лист — с указанием, какой именно признак не совпал по каждой записи.
Кафедра и научный руководитель. Фиктивный источник в списке ВКР или диссертации до сих пор обнаруживался только целенаправленной проверкой — если руководитель сам решал перепроверить ссылки. Теперь недействительные записи видны в том же отчёте, что заимствования и ИИ-фрагменты: отдельного действия не требуется, а разговор со студентом начинается с конкретной ссылки, а не с общих подозрений.
Редакция научного журнала. Масштаб проблемы для издательского контура зафиксирован в международной литературе: аудит 2,5 млн статей PubMed, опубликованный в The Lancet в 2026 году, показал рост сфабрикованных ссылок на порядок за последние три года — до одной статьи из 277 в начале 2026-го, — причём такие ссылки внешне корректны: реальные авторы, правдоподобные названия, аккуратный формат. Известны отзывы статей, где вымышленными оказывались от четверти до большинства ссылок в списке. Формальная вычитка списка такие записи не ловит — их выявляет только сверка с реестрами публикаций, которую функция выполняет автоматически: редактор работает не со всем списком, а с расхождениями.
Заключение
Приведённый обзор показывает, что трудности библиографического описания носят одновременно когнитивный, нормативный и технический характер. Их преодоление требует как повышения квалификации авторов, так и внедрения умных инструментов верификации. Качественные учебно-методические материалы, разбирающие типичные ошибки на конкретных примерах, остаются необходимым фундаментом. Однако лавинообразный рост научных публикаций делает ручную проверку всё менее реалистичной.
В этом контексте обновление системы Руконтекст с функцией автоматического распознавания библиографических ссылок демонстрирует перспективный путь: система не просто выявляет некорректные заимствования, но и сигнализирует о недостоверных или неполных библиографических записях, классифицируя их по степени надёжности. В совокупности с другими мерами — строгими редакционными политиками, развитием баз DOI и единых репозиториев — такие инструменты способны качественно повысить культуру цитирования, укрепить академическую честность и обеспечить подлинную воспроизводимость научных результатов.