Обновление детектора ИИ-текста: 1 ложное срабатывание на 8000
Обновили наш модуль обнаружения текста, созданного генеративным искусственным интеллектом. К функции выявления подозрительных фрагментов добавлены новые инструменты анализа и данные о точности детектора, полученные в процессе внутреннего тестирования.
Ранее система помечала документы, содержащие вероятно сгенерированные ИИ-фрагменты, выделением в интерактивном просмотре и присваивала проверке статус «подозрительный документ». Такой же статус дублировался в кратком и расширенном отчетах, а при обнаружении ИИ-вставок выводилось предупреждение о возможных попытках обхода.
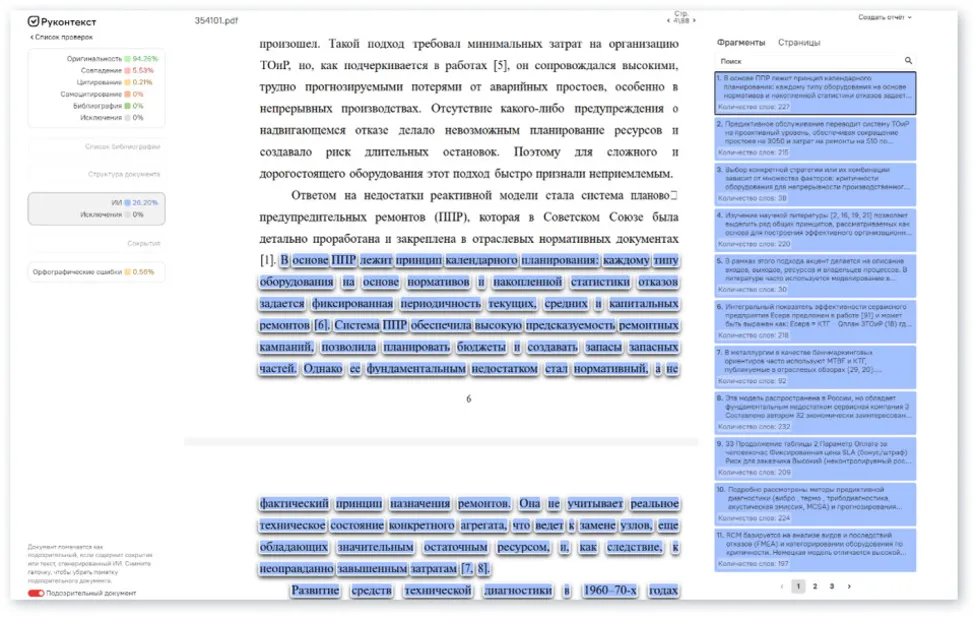
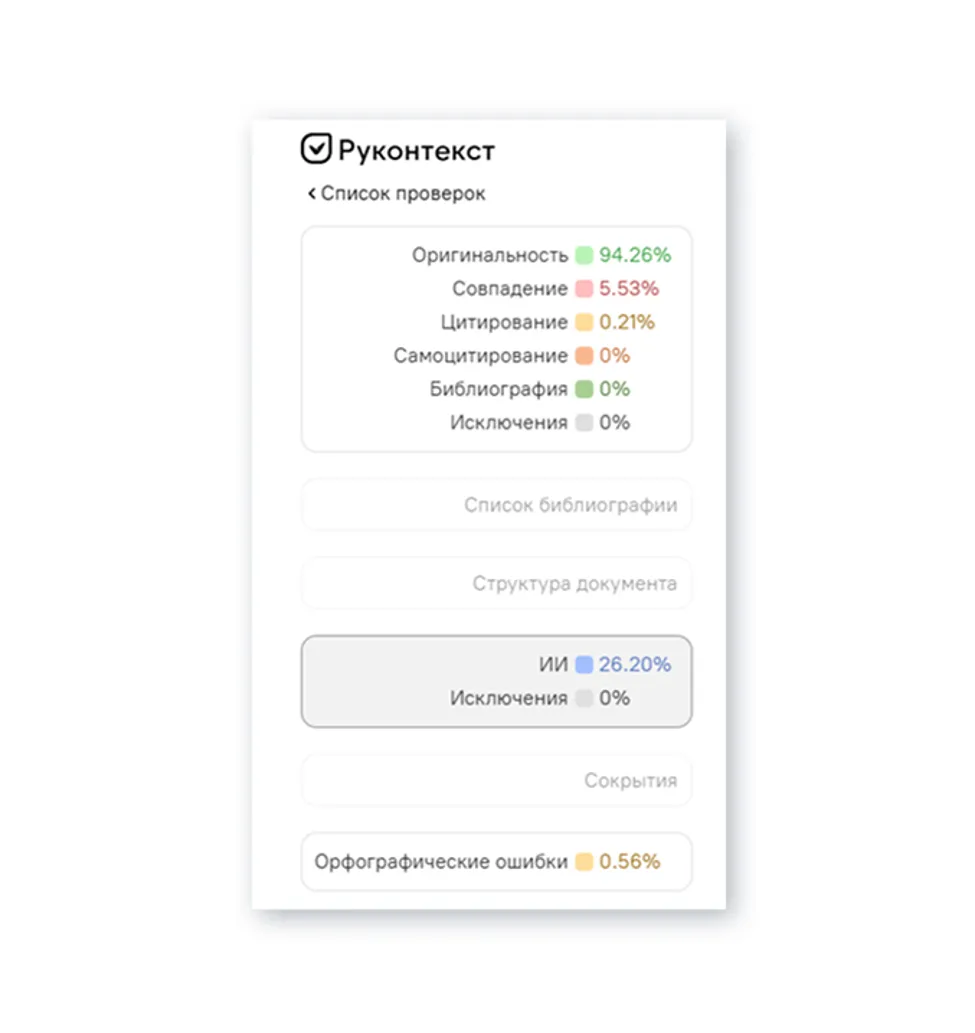
Теперь пользователи могут просматривать каждый фрагмент текста, отмеченный алгоритмом как вероятно сгенерированный, и исключать отдельные фрагменты из дальнейшего анализа. Отчет также показывает процентное соотношение текста, сгенерированного искусственным интеллектом, относительно общего объема документа.
По данным внутреннего тестирования «Руконтекста», на 8 000 проверенных научных статей пришлось только одно ложное срабатывание детектора.
«Нейросети развиваются быстро, и наша задача — чтобы инструменты анализа успевали за этим процессом. Новые функции позволяют обнаруживать ИИ-фрагменты в тексте, оценивать их долю и работать с каждым фрагментом отдельно. Наибольшее внимание уделено точности предлагаемого инструмента», — говорит Максим Дымков, генеральный директор, ООО «НЦР «Руконт».
Оригинал новости опубликован в СМИ — Компьютерра, 7 августа 2026. Настоящая версия дополнена скриншотами интерфейса.